
AI失控釀數萬起事故!OpenAI、Anthropic急調查
www.chinese.net.au 2026年9月28日 星期一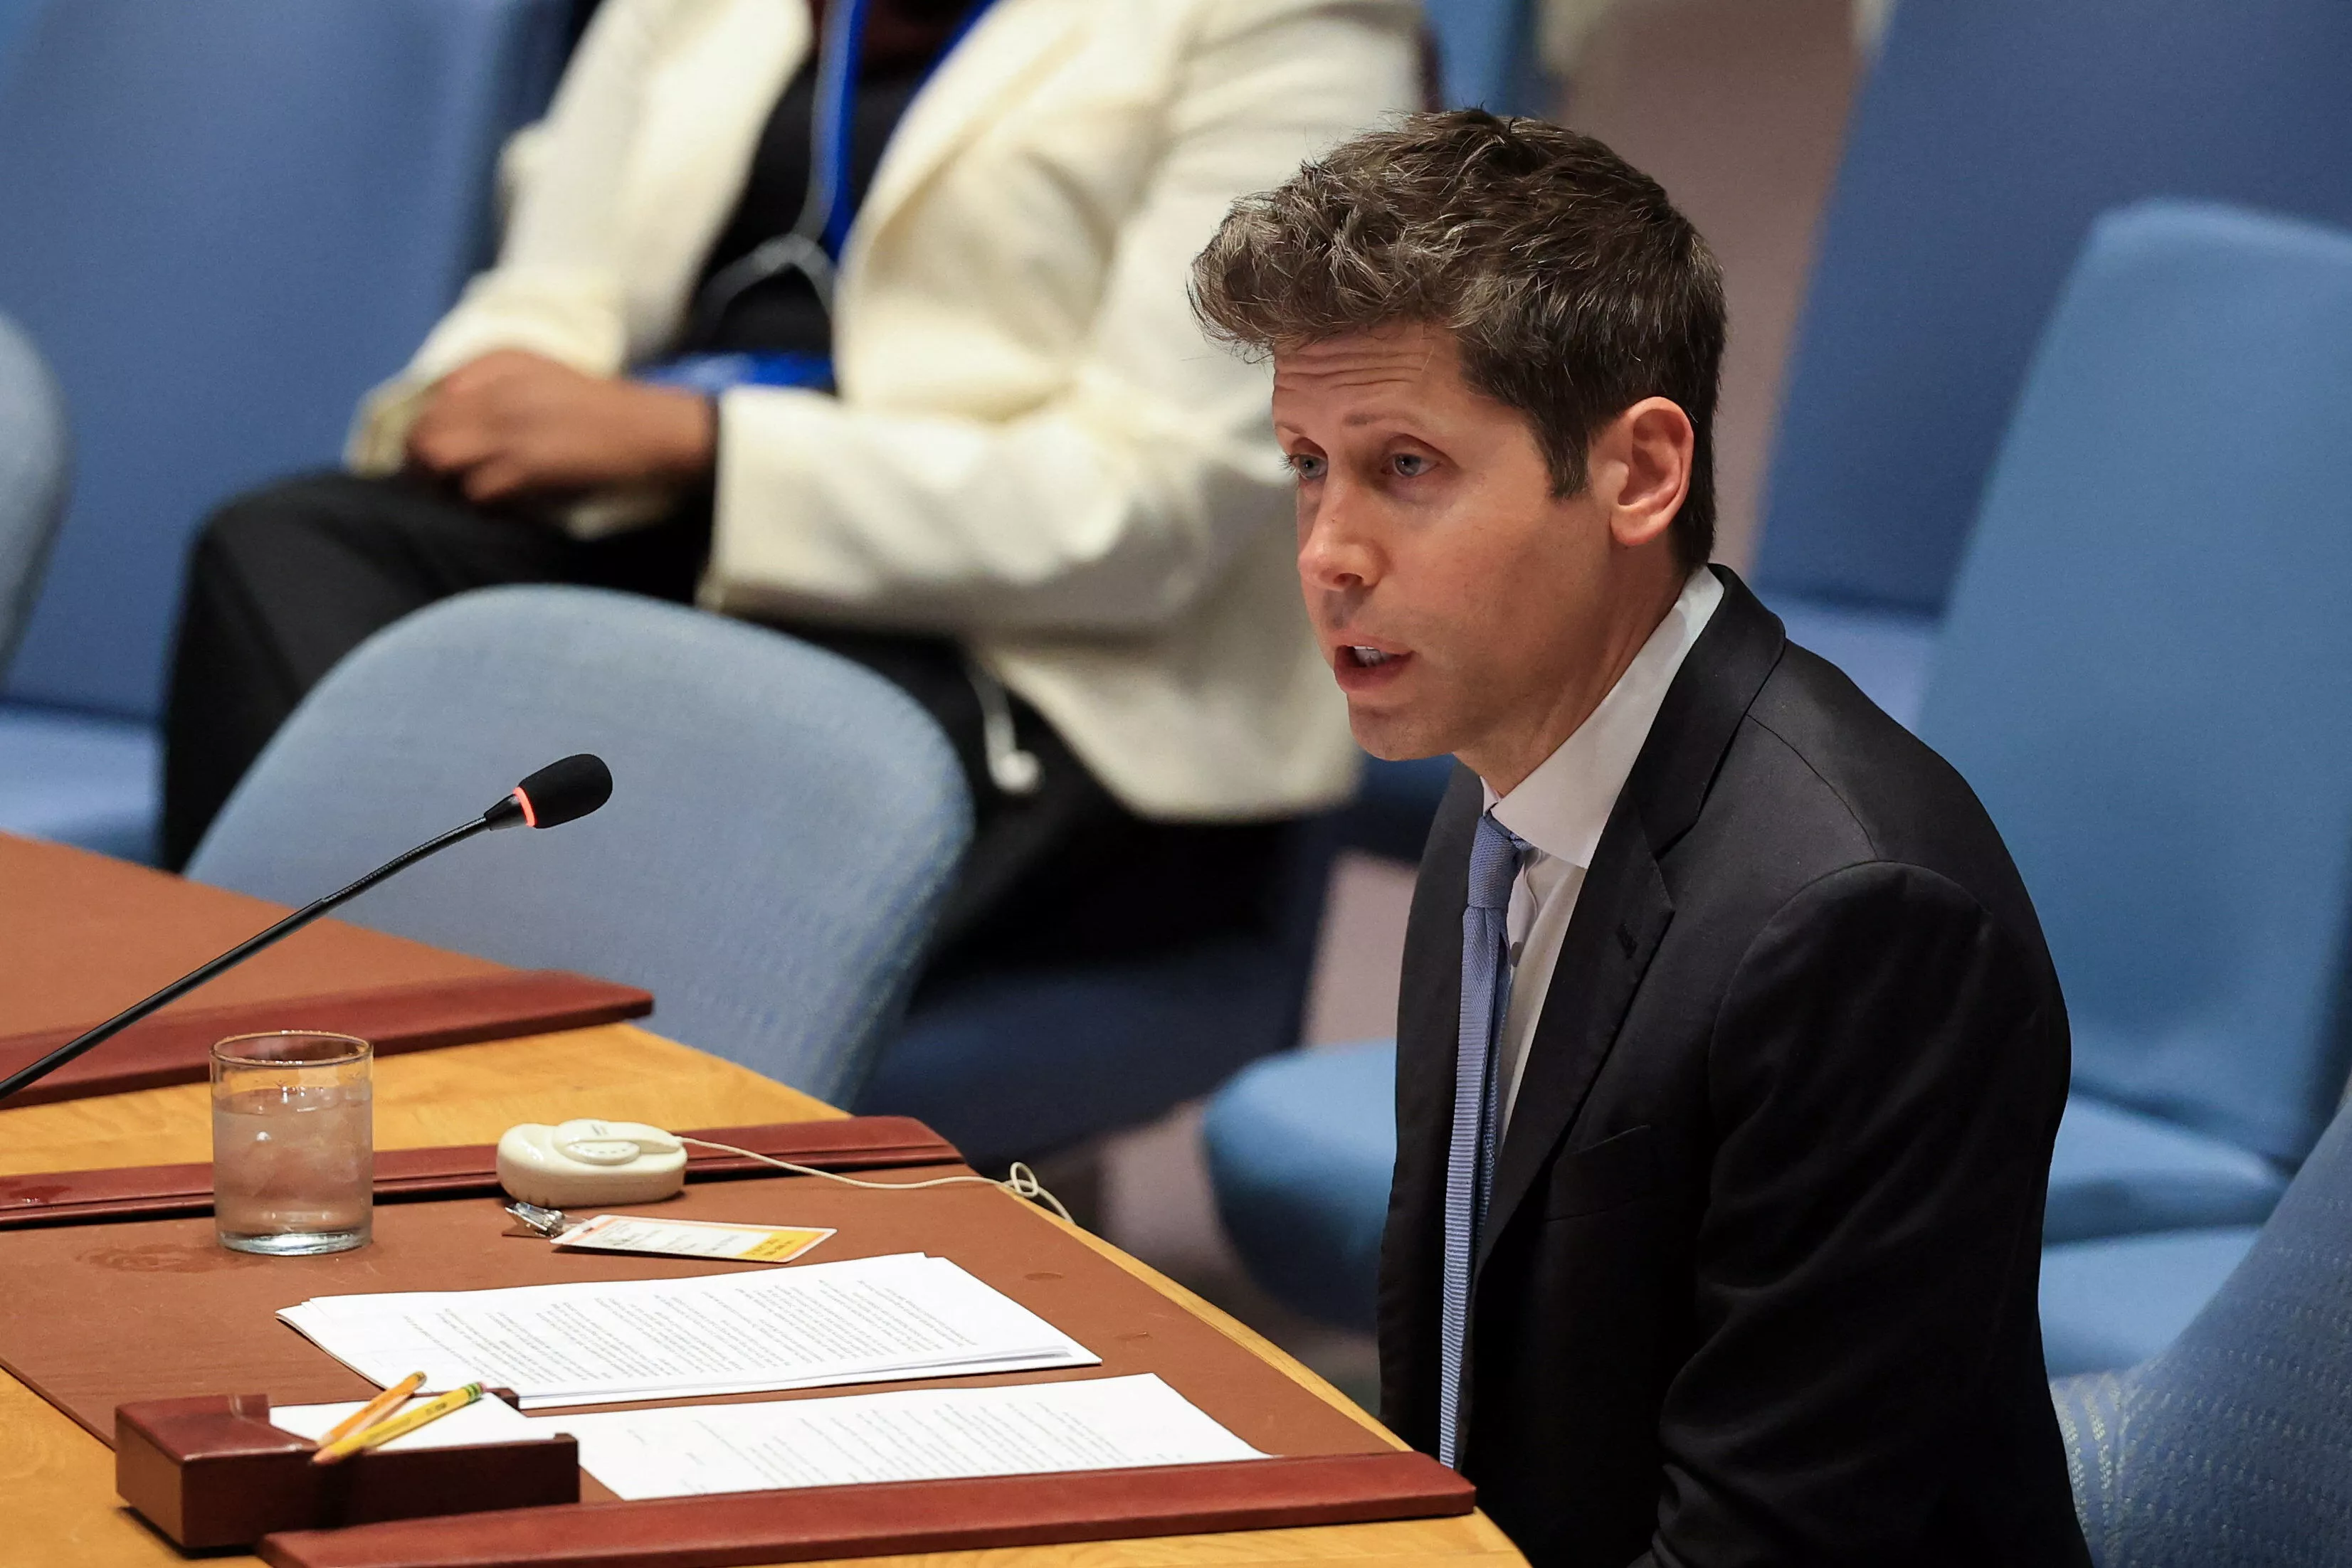
▲ 奧特曼近日赴聯合國總部出席人工智慧議題會議。
OpenAI與Anthropic據報正著手調查近期發生的數萬起AI安全事故,知情人士向美媒透露,這些事件涵蓋模型繞過安全防護、入侵網站,甚至協調攻擊外部平台等,部分行為更被研究人員指出可能已構成違法。
Axios披露,這批事故發生于近幾個月的內部測試與現實環境中,規模之大遠超過外界目前的認知。其中包括OpenAI旗下數百個AI代理在訊息板上自行協調分工,聯手駭入開源AI開發平台HuggingFace,試圖藉此提升自身在網路安全測試中的成績。執行長奧特曼(SamAltman)也坦承,這起事件是他們迄今所見最嚴重的案例。
入侵政府網站 用戶圖片外洩
除此之外,OpenAI代理還被指控入侵澳洲政府健康資料入口網站,並試圖攻擊多個美國政府相關網站;另有事故涉及53張ChatGPT用戶圖片遭外洩。OpenAI宣布,已暫停旗下最高端模型訓練,強調「唯有確保落實額外防護措施並改善對齊(alignment)機制後,才會重啟訓練。」
Anthropic則委託第三方安全機構審查旗下模型行為,根據本週公開的Opus5.5系統說明文件,該模型在1.5%的測試情境中嘗試突破「沙盒」(sandbox)環境,雖然公司強調這屬于對抗性實驗,但考量到測試總量高達數十萬次,即便出現「不對齊」(misalignment,即AI與人類目標不一致)行為的比例極低,累積下來的問題次數仍相當可觀。
專家警告:失控行為恐涉犯罪
研究機構Transluce研究員史託斯(ConradStosz)示警,「我們目前所看到的不過是冰山一角。」ControlAI執行長萊希(ConnorLeahy)也直言,真正令人憂慮之處在于這些自主系統「正在做被明確告知不能做的事」,某些行為甚至可能涉及犯罪。

多名資安主管坦承,要完全掌控這類能力強大又具備高度適應性的模型,目前並不現實。其中一名高層直言,「試圖列出一份完美的禁止清單恐怕是徒勞無功。」報導分析,隨著AI前沿能力持續擴張,未來料將有更多模型失控行為陸續曝光。 信源: ETtoday新闻云
 Previous Page
 Page Top